Теоретичний матеріал та презентація до Теми №5
| Сайт: | Навчально-інформаційний портал НУБіП України |
| Курс: | ГІС- і бази даних в охороні ґрунтів ☑️ |
| Книга: | Теоретичний матеріал та презентація до Теми №5 |
| Надруковано: | Гість-користувач |
| Дата: | суботу, 17 жовтня 2026, 11:29 |
Опис
В цій книзі подано короткий конспект лекції, контрольні запитання та презентацію до теми
1. Основи SQL та його роль у базах даних
Мова структурованих запитів (SQL — Structured Query Language) є загальноприйнятим міжнародним стандартом (ISO/IEC 9075) декларативного програмування, призначеним для створення, модифікації, управління та вибірки даних у реляційних (РСУБД) та об'єктно-реляційних системах управління базами даних (ОРСУБД) [8; 14].
На відміну від імперативних мов програмування (Python, C++), SQL є декларативною мовою: користувач описує що саме потрібно отримати у результаті, а як саме виконувати запит (вибір індексів, алгоритмів об'єднання таблиць та порядок сканування диска) визначає внутрішній планувальник запитів (Query Planner / Optimizer) СУБД [8].
Визначення SQL-схеми
Мову SQL можна вважати однією з головних причин комерційного успіху реляційних баз даних. Оскільки вона стала стандартом для реляційних баз даних, користувачі менше переймалися питаннями перенесення своїх застосунків з інших типів систем (наприклад, мережевих або ієрархічних) на реляційні системи.
Це пояснюється тим, що навіть якщо користувачів переставав задовольняти конкретний продукт — реляційна СКБД, — перехід на іншу реляційну СКБД не вимагав надмірних витрат часу чи коштів, адже обидві системи дотримувалися одних і тих самих мовних стандартів. Звісно, на практиці між різними комерційними пакетами реляційних СКБД існує чимало відмінностей. Проте, якщо користувач сумлінно використовує лише ті можливості, що входять до стандарту, і якщо обидві реляційні системи точно цей стандарт підтримують, то перехід між ними має бути значно простішим. Ще однією перевагою наявності такого стандарту є можливість писати команди в прикладній програмі для роботи з базами даних, які можуть отримувати доступ до даних, що зберігаються у двох або більше реляційних СКБД, без необхідності змінювати підмову роботи з базою даних (SQL), за умови, що обидві СКБД підтримують стандартний SQL. Назва SQL нині розшифровується як Structured Query Language (мова структурованих запитів). Спочатку ця мова мала назву SEQUEL (Structured English Query Language — мова структурованих запитів англійською мовою); її було розроблено та впроваджено в підрозділі IBM Research як інтерфейс для експериментальної системи реляційних баз даних під назвою SYSTEM R. Сьогодні SQL є стандартною мовою для комерційних реляційних СКБД. Спільна робота Американського національного інституту стандартів (ANSI) та Міжнародної організації зі стандартизації (ISO) призвела до появи стандартної версії SQL (ANSI 1986), відомої як SQL-86 або SQL1. Згодом було розроблено переглянутий і значно розширений стандарт SQL-92 (також відомий як SQL2). Наступним визнаним стандартом став SQL:1999, який на етапі розробки мав назву SQL3. Двома пізнішими оновленнями стандарту стали SQL:2003 та SQL:2006; серед іншого, вони додали до мови підтримку можливостей XML. Ще одне оновлення, випущене у 2008 році, інтегрувало в SQL додаткові функції об'єктно-орієнтованих баз даних.
SQL — це комплексна мова для роботи з базами даних: вона містить команди для визначення даних, виконання запитів та оновлення інформації. Отже, ця мова поєднує в собі функції як DDL, так і DML. Крім того, вона містить засоби для визначення представлень (views) у базі даних, налаштування системи безпеки та авторизації, встановлення обмежень цілісності та керування транзакціями. Також передбачено правила вбудовування інструкцій SQL у мови програмування загального призначення, такі як Java, COBOL або C/C++.
Пізніші стандарти SQL (починаючи з SQL:1999) поділяються на базову специфікацію та спеціалізовані розширення. Базова частина має бути реалізована всіма розробниками реляційних систем керування базами даних (РСКБД), що відповідають стандарту SQL. Розширення можуть реалізовуватися як додаткові модулі, що купуються окремо для вирішення специфічних завдань, таких як інтелектуальний аналіз даних (data mining), робота з просторовими та часовими даними, створення сховищ даних, оперативна аналітична обробка (OLAP), робота з мультимедійними даними тощо.
Визначення даних і типи даних у SQL
У SQL терміни «таблиця», «рядок» і «стовпець» використовуються як відповідники формальних термінів реляційної моделі: «відношення», «кортеж» і «атрибут» відповідно. Ми будемо вживати ці терміни як взаємозамінні. Основною командою SQL для визначення даних є інструкція CREATE; її можна використовувати для створення схем, таблиць (відношень) і доменів (а також інших об'єктів, як-от представлень, тверджень і тригерів). Оскільки специфікація SQL є дуже об’ємною, тут наведено опис лише найважливіших можливостей. Детальнішу інформацію можна знайти у відповідних стандартах SQL.
Типи даних атрибутів і домени в SQL. До основних типів даних, доступних для атрибутів, належать: числові типи, рядки символів, рядки бітів, логічний тип (Boolean), а також типи для зберігання дати й часу.
■ Числові типи даних включають цілі числа різного розміру (INTEGER або INT та SMALLINT) і числа з плавною комою (дійсні числа) різної точності (FLOAT або REAL та DOUBLE PRECISION). Числа з фіксованою точністю можна оголошувати за допомогою конструкції DECIMAL(i,j) — або DEC(i,j) чи NUMERIC(i,j), — де i (точність) — це загальна кількість десяткових цифр, а j (масштаб) — кількість цифр після десяткової крапки.
■ Типи даних для рядків символів можуть бути фіксованої довжини (CHAR або CHARACTER, де n — кількість символів) або змінної довжини (VARCHAR, CHAR VARYING або CHARACTER VARYING, де n — максимальна кількість символів). Літеральне рядкове значення записується в одинарних лапках (апострофах); при цьому враховується регістр символів (розрізняються великі та малі літери).
■ Типи даних для рядків бітів можуть бути фіксованої довжини n (BIT) або змінної довжини (BIT VARYING, де n — максимальна кількість бітів). Значенням за замовчуванням для n (довжини рядка символів або бітів) є 1. Літеральні рядки бітів записуються в одинарних лапках, але перед ними ставиться літера B, щоб відрізняти їх від рядків символів; ...наприклад, B‘10101’.5 Також доступний інший тип даних для бітових рядків змінної довжини — BINARY LARGE OBJECT (або BLOB); він використовується для визначення стовпців, що містять великі бінарні значення, як-от зображення. Як і у випадку з CLOB, максимальну довжину BLOB можна задавати в кілобітах (K), мегабітах (M) або гігабітах (G). Наприклад, BLOB(30G) визначає максимальну довжину в 30 гігабіт.
■ Тип даних Boolean (логічний тип) має традиційні значення TRUE (істина) або FALSE (хиба). Оскільки в SQL існують значення NULL, тут застосовується тризначна логіка, тому третім можливим значенням для типу Boolean є UNKNOWN (невідомо). Питання щодо необхідності значення UNKNOWN та тризначної логіки розглядаються в розділі 5.
■ Тип даних DATE (дата) займає десять позицій і складається з компонентів YEAR (рік), MONTH (місяць) і DAY (день) у форматі YYYY-MM-DD. Тип даних TIME (час) займає щонайменше вісім позицій і складається з компонентів HOUR (година), MINUTE (хвилина) та SECOND (секунда) у форматі HH:MM:SS.
■ Тип даних TIMESTAMP (часова мітка) включає поля DATE і TIME, а також щонайменше шість позицій для десяткових часток секунди та необов’язковий кваліфікатор WITH TIME ZONE (з урахуванням часового поясу). Літеральні значення записуються як рядки в одинарних лапках із ключовим словом TIMESTAMP перед ними та пробілом між датою й часом; наприклад: TIMESTAMP ‘2008-09-27 09:12:47.648302’.
■ Ще одним типом даних, пов’язаним із DATE, TIME та TIMESTAMP, є тип INTERVAL (інтервал). Він визначає інтервал — відносне значення, яке можна використовувати для збільшення або зменшення абсолютного значення дати, часу чи часової мітки. Інтервали поділяються на інтервали типу YEAR/MONTH (рік/місяць) або DAY/TIME (день/час). Формати DATE, TIME та TIMESTAMP можна розглядати як особливий вид рядків. Тому їх, як правило, можна використовувати в операціях порівняння рядків, перетворюючи (або приводячи) їх до еквівалентних рядкових значень.
2. Основні оператори SQL
Класифікація операторів мови SQL
За функціональним призначенням підмножини команд SQL поділяються на 5 основних категорій [8; 14]:
DDL (Data Definition Language — мова визначення даних): оператори створення, зміни та видалення схем, таблиць, індексів, просторових обмежень та уявлень (CREATE, ALTER, DROP, TRUNCATE).
DML (Data Manipulation Language — мова маніпулювання даними): оператори додавання, оновлення та вилучення атрибутивних і просторових записів (INSERT, UPDATE, DELETE).
DQL (Data Query Language — мова запитів): оператор вибірки даних (SELECT), що становить основу аналітичної роботи в СУБД.
DCL (Data Control Language — мова управління доступом): адміністрування прав доступу користувачів та ролей до об'єктів бази геоданих (GRANT, REVOKE).
TCL (Transaction Control Language — мова управління транзакціями): забезпечення атомарності та цілісності при групових операціях з даними (COMMIT, ROLLBACK, SAVEPOINT).
Функціонування бази геоданих базується на трьох ключових групах операторів SQL: DDL (визначення структури), DML (управління вмістом) та DQL (формування запитів) [8; 14]. У геоінформаційних СУБД ці оператори розширені для роботи з об'єктами OGC Simple Features [27; 29].
Оператори визначення даних (DDL — Data Definition Language)
DDL-оператори відповідають за формування фізичної схеми бази геоданих: створення, модифікацію та видалення таблиць, просторових колон, індексів та обмежень цілісності [8].
· CREATE TABLE: створення нової таблиці з визначенням типів даних (числові, текстові, часові, просторові) та обмежень (Primary Key, Foreign Key, CHECK, NOT NULL).
· ALTER TABLE: модифікація структури існуючої таблиці (додавання нових атрибутів, зміна типів даних, додавання просторових індексів чи обмежень).
· DROP TABLE: повне вилучення таблиці та її даних із баз геоданих.
· TRUNCATE TABLE: миттєве очищення всіх рядків таблиці із збереженням її DDL-структури.
Оператори маніпулювання даними (DML — Data Manipulation Language)
DML-оператори забезпечують внесення, оновлення та вилучення атрибутивних і просторових записів у таблицях [14].
· INSERT INTO: додавання нових рядків. Просторова геометрія передається у текстовому форматі WKT (Well-Known Text) або EWKT за допомогою функцій ST_GeomFromText() або ST_SetSRID() [27; 29].
· UPDATE: коригування значення атрибутів або геометричного положення об'єктів за визначеною умовою.
· DELETE FROM: вилучення записів, що відповідають умові предикату.
Оператор вибірки (DQL — Data Query Language): Структура SELECT
Оператор SELECT є головним інструментом геоаналітики, витягування та трансформації даних [8].
Написання команд SQL
У цьому розділі ми стисло описуємо структуру інструкції SQL та позначення, що використовуються для визначення формату різних конструкцій SQL. Інструкція SQL складається із зарезервованих слів і слів, визначених користувачем. Зарезервовані слова є незмінною частиною мови SQL і мають фіксоване значення. Їх слід писати точно так, як вимагає стандарт; вони не можуть бути розірвані переходом на новий рядок. Слова, визначені користувачем, створюються самим користувачем (відповідно до певних синтаксичних правил) і позначають назви різних об'єктів бази даних, таких як таблиці, стовпці, представлення, індекси тощо. Розміщення слів в інструкції також підпорядковується певним синтаксичним правилам. Хоча стандарт цього не вимагає, багато діалектів SQL передбачають використання спеціального символу для позначення завершення кожної інструкції (зазвичай це крапка з комою «;»).
Більшість компонентів інструкції SQL нечутливі до регістру, тобто літери можна вводити як у верхньому, так і в нижньому регістрі. Важливим винятком із цього правила є символьні літерали (рядкові константи), які слід вводити точно так, як вони представлені в базі даних.
Хоча SQL має вільний формат запису, інструкція або набір інструкцій легше читаються, якщо використовувати відступи та відповідне розташування рядків. Наприклад:
• кожна частина (пункт) інструкції має починатися з нового рядка;
• початок кожної частини має бути вирівняний відносно початку інших частин;
• якщо частина інструкції складається з кількох елементів, кожен з них слід розміщувати в окремому рядку з відступом відносно початку цієї частини, щоб показати взаємозв'язок між ними.
Прості запити
Призначення оператора SELECT — отримання та відображення даних з однієї або кількох таблиць бази даних. Це надзвичайно потужна команда, здатна в межах одного оператора виконувати дії, еквівалентні операціям реляційної алгебри: вибору (selection), проєкції (projection) та з’єднанню (join).
Вибір рядків (умова WHERE)
Однак часто виникає потреба обмежити кількість рядків, що отримуються в результаті запиту. Це можна зробити за допомогою умови WHERE, яка складається з ключового слова WHERE та умови пошуку, що визначає, які саме рядки слід вибрати. Існує п’ять основних умов пошуку (або предикатів, згідно з термінологією ISO):
• Порівняння — порівняння значення одного виразу зі значенням іншого виразу.
• Діапазон — перевірка того, чи потрапляє значення виразу в заданий діапазон значень.
• Належність до множини — перевірка того, чи дорівнює значення виразу одному зі значень у заданій множині.
• Відповідність шаблону — перевірка того, чи відповідає рядок заданому шаблону.
• Null — перевірка того, чи містить стовпець значення NULL (невідоме значення).
Умова WHERE є еквівалентом операції вибору (selection) у реляційній алгебрі, що розглядалася раніше.
У SQL доступні такі прості оператори порівняння:
= дорівнює
< > не дорівнює (стандарт ISO)
< менше ніж
> більше ніж
! = не дорівнює (допускається в деяких діалектах)
< = менше або дорівнює
> = більше або дорівнює
Використання агрегатних функцій SQL
Окрім отримання рядків і стовпців із бази даних, часто виникає потреба виконати певне підсумовування або агрегування даних — подібно до підрахунку підсумкових значень у нижній частині звіту.
Стандарт ISO визначає п’ять агрегатних функцій:
COUNT — повертає кількість значень у вказаному стовпці;
SUM — повертає суму значень у вказаному стовпці;
AVG — повертає середнє значення у вказаному стовпці;
MIN — повертає найменше значення у вказаному стовпці;
MAX — повертає найбільше значення у вказаному стовпці.
3. Запити з умовами та об’єднаннями
Ефективний аналіз даних у реляційних СУБД базується на здатності прецизійно фільтрувати записи за певною сукупністю умов та комплексувати інформацію з декількох пов'язаних таблиць схеми бази геоданих [8; 14].
Запити до кількох таблиць
Усі розглянуті досі приклади мають суттєве обмеження: стовпці, що мають відображатися в результуючій таблиці, повинні походити з однієї таблиці. У багатьох випадках цього недостатньо. Щоб об’єднати стовпці з кількох таблиць у результуючу таблицю, необхідно використовувати операцію з’єднання (join). Операція з’єднання в SQL об’єднує інформацію з двох таблиць, утворюючи пари пов’язаних рядків із цих таблиць. До результуючої таблиці потрапляють ті пари рядків, у яких відповідні стовпці обох таблиць мають однакові значення.
Якщо потрібно отримати інформацію з більш ніж однієї таблиці, вибір стоїть між використанням підзапиту та операції з’єднання. Якщо результуюча таблиця повинна містити стовпці з різних таблиць, необхідно використовувати з’єднання. Для виконання з’єднання достатньо вказати кілька імен таблиць у реченні FROM, розділивши їх комами, і, як правило, додати речення WHERE для визначення стовпця (або стовпців), за якими здійснюється з’єднання. Також можна використовувати псевдонім (аліас) для таблиці, зазначеної в реченні FROM. У такому разі псевдонім відокремлюється від імені таблиці пробілом. Псевдонім можна використовувати для уточнення імені стовпця, якщо виникає неоднозначність щодо джерела цього стовпця. Його також можна використовувати як скорочене позначення імені таблиці. Якщо псевдонім визначено, його можна використовувати замість імені таблиці в будь-якому місці запиту.
Концептуально процедура формування результату оператора SELECT із використанням з’єднання виглядає так:
1) Утворюється декартів добуток таблиць, зазначених у реченні FROM.
2) Якщо присутнє речення WHERE, до кожного рядка отриманої таблиці застосовується умова пошуку; зберігаються лише ті рядки, що задовольняють цю умову. З погляду реляційної алгебри ця операція являє собою обмеження декартового добутку.
3) Для кожного з отриманих рядків визначаються значення всіх елементів зі списку SELECT, що формує один рядок результуючої таблиці.
4) Якщо вказано SELECT DISTINCT, із результуючої таблиці видаляються всі дубльовані рядки. У реляційній алгебрі кроки 3 і 4 еквівалентні операції проекції результату обмеження на стовпці, зазначені у списку SELECT.
5) Якщо присутній оператор ORDER BY, слід відсортувати результуючу таблицю відповідним чином.
Об'єднання результуючих таблиць (UNION, INTERSECT, EXCEPT)
У SQL для об'єднання результатів двох або більше запитів в одну результуючу таблицю можна використовувати стандартні теоретико-множинні операції: об'єднання (Union), перетин (Intersection) та різницю (Difference):
• Об'єднання (Union) двох таблиць, A та B, — це таблиця, що містить усі рядки, які є в першій таблиці A, у другій таблиці B або в обох таблицях.
• Перетин (Intersection) двох таблиць, A та B, — це таблиця, що містить усі рядки, спільні для обох таблиць A та B.
• Різниця (Difference) двох таблиць, A та B, — це таблиця, що містить усі рядки, які є в таблиці A, але відсутні в таблиці B.
Існують обмеження щодо таблиць, які можна об'єднувати за допомогою цих операцій; найважливіше з них полягає в тому, що таблиці повинні бути сумісними для об'єднання (union-compatible), тобто мати однакову структуру. Це означає, що таблиці повинні містити однакову кількість стовпців, а відповідні стовпці — мати однакові типи даних і розміри. Користувач самостійно відповідає за те, щоб значення даних у відповідних стовпцях належали до одного й того самого домену.
ПРИКЛАД
Вибірка ділянок із вмістом гумусу від 3.0 до 5.0% та високою кислотністю (pH < 5.5)
SELECT polygon_id, soil_type, humus_pct, ph_water
FROM soil_chemistry_samples
WHERE (humus_pct BETWEEN 3.0 AND 5.0)
AND ph_water < 5.5
AND land_use_type IN ('Рілля', 'Пасовище')
AND inspector_notes IS NOT NULL;
4. Просторові запити у SQL
Просторові запити є розширенням реляційної мови SQL, що дозволяє виконувати вибірку, обчислення та аналіз даних на основі їхнього географічного положення, форми та топологічних взаємозв'язків [27; 29].
Просторовий SQL (Spatial SQL) – це сумісна мова для роботи з просторовими даними, що дозволяє використовувати геопросторовий аналіз, просторову науку про дані та розробку додатків [20].
Вона надає користувачам ГІС та геопросторових даних можливість працювати в тому ж місці, що й інші дані в базах даних та сховищах даних, усуваючи традиційну ізоляцію між ГІС та іншими сферами організації.
Просторовий SQL підтримує розширені операції, такі як просторове моделювання та машинне навчання, в тому ж місці, де знаходяться дані [20].
Spatial SQL - це не просто мова запитів. Вона переростає ці межі, а сфера її застосування виходить далеко за межі простого зберігання просторових даних у базах даних. Вона забезпечує швидший просторовий аналіз, підтримує роботу просторових застосунків, уможливлює аналіз просторових даних (spatial data science) і машинне навчання, а також багато іншого [20].
Spatial SQL — це універсальна мова для роботи з просторовими даними, що забезпечує можливості геопросторового аналізу, аналізу просторових даних і розробки застосунків.
Вона дозволяє фахівцям у сфері ГІС та геопросторових технологій працювати з даними безпосередньо там, де вони зберігаються (у базах даних і сховищах даних), усуваючи традиційні бар'єри між ГІС та іншими підрозділами організації.
Spatial SQL підтримує виконання складних операцій, таких як просторове моделювання та машинне навчання, безпосередньо в середовищі зберігання даних [20].
Spatial SQL використовує ті самі елементи й структуру, що й стандартна мова SQL, але дозволяє працювати з додатковими типами даних: GEOMETRY (геометрія) або GEOGRAPHY (географія).
Як змінюється Spatial SQL?
Spatial SQL еволюціонує від компонента мови запитів до бази даних у повноцінний інтегрований елемент сучасного стеку ГІС та геопросторових технологій. Щоб зрозуміти суть цих змін, розгляньмо широкий спектр сценаріїв використання Spatial SQL та ролі фахівців, які їх застосовують [20]:
Адміністратор бази даних може використовувати Spatial SQL для зберігання, керування, оновлення та надання кінцевим користувачам доступу до геопросторових даних у різних екземплярах баз даних (це найбільш традиційний сценарій використання Spatial SQL). Такий фахівець може створювати в базі даних збережені процедури та тригери для оновлення даних у міру їх надходження, а також автоматизувати такі процеси, як зміна проєкцій, маніпуляції з даними, форматування тощо. База даних також може бути інтегрована з іншими інструментами, що надають користувачам можливість переглядати дані, виконувати запити та отримувати до них доступ. Зазвичай робота з базою даних здійснюється через такі інструменти, як pgAdmin або psql (командний рядок) у PostGIS, або ж через графічні інтерфейси чи інструменти командного рядка для хмарних сховищ даних [20].
ГІС-аналітик може виступати кінцевим користувачем даних, що зберігаються в базі даних із підтримкою Spatial SQL, використовуючи їх для виконання запитів, аналізу та візуалізації. Аналітики використовують набори даних (окремо або в поєднанні) для отримання цінної інформації, застосовуючи функції просторових відношень у Spatial SQL та інші аналітичні інструменти. Як правило, вони виконують запити до даних, не вносячи в них змін чи оновлень (за винятком випадків, коли створюють власні копії даних). Доступ до даних та їх візуалізація здійснюються за допомогою Python, Jupyter Notebooks, QGIS, CARTO та інших інструментів. Використання PostGIS та QGIS [20].
Фахівець із просторових даних (spatial data scientist) застосовує просторовий SQL для вирішення різноманітних завдань. Це включає отримання даних із баз даних для подальшого аналізу в Python шляхом їх об’єднання з іншими просторовими або непросторовими наборами даних. Також можуть використовуватися складніші концепції SQL для ранжування, застосування віконних функцій, просторової кластеризації, агрегації та аналізу просторових взаємозв’язків — операцій, які ефективніше виконувати безпосередньо в SQL. Крім того, просторовий SQL застосовується для аналізу просторових зв’язків і збагачення даних, що слугують ознаками (features) для моделей машинного навчання (процес, відомий як просторова інженерія ознак). Зазвичай доступ до цих даних здійснюється через середовища на кшталт Jupyter Notebooks, а в роботі використовуються як бази даних (наприклад, PostGIS), так і сховища даних (наприклад, BigQuery) [20].
Інженер із геопросторових даних (geospatial data engineer) може отримувати доступ до просторового SQL та використовувати його різними способами. Наприклад, він може застосовувати SQL у межах GDAL для виконання операцій із перетворення та керування даними (зокрема, з використанням SpatiaLite). Також можливе використання бази даних разом із сервісами для роботи з тайлами або просторовими об’єктами (feature services), такими як pg_featureserv чи pg_tileserv. SQL використовується для перетворення та об’єднання різних наборів даних із метою створення нової інформації, очищення й перевірки даних, видобування та трансформації значень із різних стовпців, а також для підготовки наборів даних для бізнес-користувачів. Для керування великими обсягами даних та їх завантаження застосовуються сховища на кшталт BigQuery та інструменти на зразок Dataflow з бібліотекою geobeam. У роботі використовуються різноманітні засоби: від командного рядка та настільних програм (як-от QGIS) до інтерфейсів баз даних, скриптів на Python тощо.
Звісно, просторова SQL (spatial SQL) як мова - це , по суті, звичайна SQL, однак вона дозволяє реалізувати безліч додаткових сценаріїв використання; саме ці можливості (і не тільки вони) роблять просторову SQL такою унікальною та потужною.
Як у базах даних, так і у сховищах даних просторову SQL можна використовувати для [20]:
- Запитів до просторових наборів даних та управління ними
- Управління системами координат (проєкціями) та перепроєціювання даних
- Зберігання просторових даних у різних форматах (WKT, GeoJSON тощо)
- Аналізу та розуміння різноманітних типів просторових взаємозв’язків
- Виконання просторової кластеризації та аналізу найближчих сусідів
- Перетворення геометрій за допомогою буферних зон, діаграм Вороного та опуклих чи увігнутих оболонок (hulls)
- Обчислення відстаней — як за прямою лінією, так і з урахуванням кривизни Землі
- Роботи з 3D-даними (запити та управління)
- Створення тригерів для зміни й оновлення даних на основі певних подій, наприклад, операції INSERT у конкретну таблицю
- Підключення до API та інших зовнішніх сервісів
- Створення користувацьких функцій іншими мовами програмування, такими як Python, JavaScript та SQL
- Виконання статистичного аналізу та завдань машинного навчання за допомогою спеціальних функцій та інструментів (наприклад, BigQuery ML)
- Зберігання неструктурованих даних (наприклад, у форматі JSON) та управління ними
- Виведення даних у різних форматах, зокрема GeoJSON або Shapefile
- Створення та генерування тайлів карти для фронтенд-застосунків
5. SQL і реляційна алгебра
Мова запитів SQL базується на математичному фундаменті реляційної алгебри, сформульованої Едгаром Коддом у 1970 році [11; 8]. Розуміння цього зв'язку є критично важливим для оптимізації складних аналітичних і просторових запитів у геоінформаційних СУБД.
Основна відмінність між реляційною алгеброю та мовою SQL полягає у парадигмі опису операцій [8; 14]:
Реляційна алгебра є процедурною мовою: вона визначає послідовність алгебраїчних операцій, які потрібно виконати над відношеннями (таблицями), щоб отримати підсумкове відношення.
SQL є декларативною мовою: розробник описує у запиті який саме результат потрібен (що отримати), а СУБД самостійно трансформує декларативний запит у еквівалентне алгебраїчне дерево операцій (як обчислити).
Властивість замкненості (Relational Closure) гарантує, що аргументами будь-якої операції реляційної алгебри є відношення (таблиці), і результатом її виконання також завжди є відношення [8].
Реляційна алгебра визначає, як отримати потрібну інформацію та як побудувати відношення на основі одного або кількох інших відношень. Реляційна алгебра, що походить від логіки першого порядку (та алгебри множин), оперує множиною скінченних відношень, замкненою відносно певних операторів. Ці оператори діють на одне або кілька відношень, результатом чого є нове відношення. Реляційна алгебра є частиною інформатики [14].
З реляційною алгеброю пов’язане поняття замкненості. Замкненість означає, що реляційні вирази можна вкладати один в одного. Наприклад, операцію, результатом якої є нове відношення, можна взяти в дужки та використати в іншому виразі. Відношення є замкненими відносно операцій реляційної алгебри.
Визначення реляційної алгебри
Домен: множина відношень
Базові оператори: вибір (select), проекція (project), об'єднання (union), різниця множин (set difference), декартів (перехресний) добуток (Cartesian product) [14].
Похідні оператори: перетин множин (intersection), ділення (division), з'єднання (join)
Процедурність: реляційний вираз визначає запит шляхом опису алгоритму (послідовності застосування операторів) для отримання результату виразу
Е. Ф. Кодд (1972) запропонував 8 операцій, що використовуються в реляційній алгебрі. Нижче наведено 5 фундаментальних операторів: вибір; проекція; декартів добуток; об'єднання; різниця множин [14].
Інші 3 оператори можуть бути визначені через ці фундаментальні оператори; вони наведені нижче: з'єднання; перетин; ділення.
Унарні оператори над відношеннями: вибір і проекція. Операції вибору та проекції є унарними, оскільки вони виконуються над одним відношенням. Інші операції працюють із парами відношень і тому називаються бінарними. У наведених нижче визначеннях нехай R і S — два відношення, визначені відповідно на наборах атрибутів A = (a1, a2, ..., aN) та B = (b1, b2, ..., bM).
Оператори: <, £, ³, >, =, ¹
Проста умова вибору:
– <атрибут> оператор <константа>
– <атрибут> оператор <атрибут>
– <умова> AND <умова>
– <умова> OR <умова>
– NOT <умова>
Вибір (або обмеження) s предикат(R). Операція вибору виконується над одним відношенням R і визначає відношення, що містить лише ті кортежі з R, які задовольняють задану умову (предикат) [14].
Проекція π a1, ..., an(R). Операція проекції виконується над одним відношенням R і визначає відношення, що містить вертикальну підмножину R, виділяючи значення вказаних атрибутів і усуваючи дублікати.
Бінарні реляційні операції [14].
Об'єднання R È S. Об'єднання двох відношень R і S визначає відношення, що містить усі кортежі з R, або з S, або з обох відношень (R і S), причому дубльовані кортежі усуваються. R і S повинні бути сумісними для об'єднання.
Якщо R і S мають відповідно I та J кортежів, їхнє об'єднання отримують шляхом злиття в одне відношення, що містить щонайбільше (I + J) кортежів. Об'єднання можливе лише тоді, коли схеми двох відношень збігаються, тобто вони мають однакову кількість атрибутів, а кожна пара відповідних атрибутів має однакову доменну область. Іншими словами, відношення повинні бути сумісними для об'єднання. Зауважте, що назви атрибутів не враховуються при визначенні сумісності для об'єднання. У деяких випадках для забезпечення сумісності двох відношень можна використовувати операцію проекції [14].
Різниця множин. R − S. Операція різниці множин визначає відношення, що складається з кортежів, які є у відношенні R, але відсутні в S. R і S повинні бути сумісними для об'єднання [14].
Перетин. R ∩ S. Операція перетину визначає відношення, що складається з усіх кортежів, які є як у R, так і в S. R і S повинні бути сумісними для об'єднання. Декартів добуток. R × S. Операція декартового добутку визначає відношення, що є результатом з’єднання кожного кортежу відношення R з кожним кортежем відношення S [14].
Декартів добуток (R × S). Операція декартового добутку визначає відношення, що утворюється шляхом з’єднання кожного кортежу відношення R з кожним кортежем відношення S [14].
Операція декартового добутку перемножує два відношення, утворюючи нове відношення, яке складається з усіх можливих пар кортежів із цих двох відношень. Отже, якщо одне відношення має I кортежів і N атрибутів, а інше — J кортежів і M атрибутів, то результуюче відношення міститиме (I × J) кортежів із (N + M) атрибутами. Можлива ситуація, коли обидва відношення мають атрибути з однаковими назвами. У такому разі до назв атрибутів додається префікс із назвою відношення, щоб забезпечити унікальність назв атрибутів у межах відношення [14].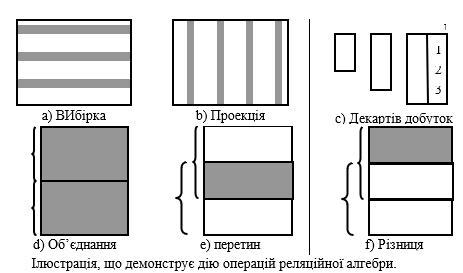
6. Контрольні запитання
-
Що таке SQL і для чого він використовується?
-
Які основні оператори SQL ви знаєте?
-
Для чого використовується оператор
SELECT? -
Яка різниця між
INSERT,UPDATEтаDELETE? -
Як працює оператор
WHEREу SQL? -
Що таке
JOINі які його види існують? -
Які агрегатні функції SQL застосовуються для аналізу даних?
-
Що таке просторові розширення SQL і навіщо вони потрібні?
-
Які приклади просторових запитів можна навести у PostGIS?
-
Які операції реляційної алгебри реалізуються у SQL та як вони співвідносяться з його командами?
7. Презентація
Презентація (завантажити тут)
Список джерел
1. Добряк Д. С., Канаш О. П., Бабміндра Д. І., Розумний В. М. Класифікація та типізація земель як наукова основа їх раціонального використання й охорони. Київ: Урожай, 2019. 208 с.
2. ДСТУ ISO 19101:2009. Географічна інформація. Еталонна модель. Київ: Держспоживстандарт України, 2012. 44 с.
3. Зацерковний В. І., Бурачек В. Г., Железняк О. О., Терещенко А. О. Геоінформаційні системи і бази даних: монографія. Ніжин: НДУ ім. М. Гоголя, 2014. 492 с.
4. Карпінський Ю. О. та ін. Основи створення інтероперабельних геопросторових даних. Київ: КНУБА, 2023. 302 с.
5. Кузьменко І. С., Москаленко А. А., Заячківська Б. Б. Проєктування бази геопросторових даних для інформаційного забезпечення систем органічного землеробства. Агроекологічний журнал. 2026. № 1. DOI: https://doi.org/10.33730/2077-4893.1.2026.354126
6. Основи геоінформаційних систем і бази даних : підручник / О. Є. Поморцева ; Харків. нац. ун-т міськ. гос-ва ім. О. М. Бекетова. – Харків : ХНУМГ ім. О. М . Бекетова, 2022. – 346 с.
7. Світличний О.О. Основи геоінформатики: Навчальний посібник /О.О.Світличний, С.В. Плотницький /За заг. ред. О.О. Світличного. Суми: ВТД«Університетська книга», 2006. 295 с.
8. Четверіков Б. В. Геоінформаційні системи і бази даних в агроінженерії: навч. посібник. Львів: Видавництво Львівської політехніки, 2024. 196 с.
9. Advanced Navigation. (n.d.). Vector data. Advanced Navigation. Retrieved September 20, 2026, from https://www.advancednavigation.com/glossary/vector-data/
10. Awati, R., Zola, A., & Fontecchio, M. (2025, June 12). What is spatial data? TechTarget. https://www.techtarget.com/data-technologies/definition/spatial-data
11. Codd E. F. A Relational Model of Data for Large Shared Data Banks. Communications of the ACM. 1970. Vol. 13, No. 6. P. 377–387.
12. DeMers M. N. Fundamentals of Geographic Information Systems. 4th ed. Wiley, 2009. 480 p.
13. Desmet, P.J.J. and Govers, G. (1996) A GIS Procedure for Automatically Calculating the USLE LS Factor on Topographically Complex Landscape Units. Journal of Soil and Water Conservation, 51, 427-433.
14. Elmasri R., Navathe S. B. Fundamentals of Database Systems. 7th ed. Pearson, 2015. 1280 p.
15. ESRI. What is GIS? URL: https://www.esri.com/en-us/what-is-gis/overview
16. European Commission. EU Soil Strategy for 2030: Reaping the benefits of healthy soils for people, food, nature and climate. Brussels: EC, 2021. 26 p. URL: https://eur-lex.europa.eu/legal-content/EN/TXT/?uri=celex:52021DC0699
17. FAO. Global Soil Partnership: GloSIS Data Exchange Specifications. Rome: FAO, 2022. 88 p.
18. FAO. Soil Data and Information Systems for Sustainable Soil Management. Rome: FAO, 2021. 96 p.
19. FAO. State of the Art Report on Global Soil Spatial Information. Rome: 19. 142 p.
20. Forrest, M. (2021, December 20). What is spatial SQL? Matt Forrest. https://forrest.nyc/what-is-spatial-sql/
21. Getis A., Ord J. K. The Analysis of Spatial Association by Use of Distance Statistics. Geographical Analysis. 2010. Vol. 24 (3). P. 189–206. DOI:10.1111/j.1538-4632.1992.tb00261.x
22. IDERA. (2025, June 5). What is conceptual data modeling? ER/Studio. https://erstudio.com/blog/conceptual-data-modeling/
23. IDERA. (2024, June 3). What is logical data modeling? ER/Studio. https://erstudio.com/blog/logical-data-modeling/
24. Kaldate, S. (2024, May 23). Evolution of Database Management System (DBMS). LinkedIn. https://ua.linkedin.com/pulse/evolution-database-management-system-dbms-soham-kaldate-k2kic
25. Moskalenko A. GIS support of forming spatial decisions on land use. Mechanization in Agriculture & Conserving of the Resources. 2021. Vol. 67, No. 3. P. 79–81.
26. Moskalenko A., Andriianov V. Development of a geospatial database for planning land protection measures against wind erosion. Zemleustriy, kadastr i monitorynh zemelʹ. 2024. No. 4. P. 107–113. DOI: https://doi.org/10.31548/zemleustriy2024.04.010
27. Open Geospatial Consortium (OGC). OpenGIS Implementation Standard for Geographic information - Simple feature access - Part 1: Common architecture. OGC 06-103r4, 2011.
28. Polytechnic. (2025). Chapter 5: Databases and queries. In An introduction to GIS. Saskatchewan Open Education Resources (SaskOER). https://www.saskoer.ca/slicegis/part/chapter-5-databases-and-queries/
29. PostGIS Documentation Team. PostGIS Manual (Versions 3.4 / 3.5). OSGeo. URL: https://postgis.net/documentation/
30. Saskatchewan Polytechnic. (2025). Chapter 4: Spatial data models. In An Introduction to GIS. https://www.saskoer.ca/slicegis/part/chapter-4-spatial-data-models
31. Spatial Eye. (n.d.). What is attribute data in GIS? https://spatial-eye.com/blog/spatial-analysis/what-is-attribute-data-in-gis/
32. Tool reference (n.d.) ArcGIS https://desktop.arcgis.com/en/arcmap/latest/tools/main/a-quick-tour-of-geoprocessing-tool-references.htm
USGS (n.d.) 3D Elevation Program https://www.usgs.gov/3d-elevation-program?
Шрифти
Розмір шрифта
Колір тексту
Колір тла
Кернінг шрифтів
Видимість картинок
Інтервал між літерами
Висота рядка
Виділити посилання
Вирівнювання тексту
Ширина абзацу